Réponse à incident
Réponse à incident sans SOC : le playbook en 5 étapes qu'une PME peut vraiment exécuter
Un playbook de réponse à incident en 5 étapes pour les PME sans SOC : préparer, détecter, confiner, rétablir, notifier. Aligné sur NIST 800-61r3, NIS2 et le CRA.
Il est 2 h du matin. Votre responsable d’exploitation appelle : impossible de se connecter, et les fichiers du lecteur partagé portent tous la même extension inconnue. Vous n’avez pas de centre opérationnel de sécurité (SOC). Vous n’avez pas d’analyste qui surveille une console 24 h/24. Vous avez une petite équipe informatique — ou une seule personne et un prestataire externe — et une entreprise qui doit ouvrir dans six heures. Ce qui décidera de l’issue n’est pas un outil que vous auriez dû acheter ; c’est un plan que vous pouvez dérouler maintenant. La plupart des entreprises de moins de 250 personnes n’en ont pas. Leur stratégie de réponse à incident tient en une phrase : « appeler l’informaticien et espérer ». Voici la version en cinq étapes que vous pouvez réellement exécuter sans SOC.
Pourquoi un SOC n’est pas le préalable
Le réflexe, quand une intrusion survient, est de croire qu’on a été battu faute d’outillage de grande entreprise. C’est faux. En avril 2025, le NIST a réécrit ses recommandations de réponse à incident (SP 800-61 révision 3) et, fait révélateur, a abandonné le cycle de vie rigide au profit d’un modèle bâti sur la préparation, la coordination de la réponse et l’amélioration continue — les fonctions du Cybersecurity Framework, pas le bon de commande d’une console 24/7. Le message est sans détour : la qualité de la réponse se décide par la préparation et les décisions prises, pas par le nombre d’écrans que vous possédez.
Une entreprise de 50 personnes n’a pas besoin d’un SOC pour bien réagir. Il lui faut un responsable désigné, une séquence écrite, des sauvegardes testées et quelqu’un à appeler. Bâtir exactement cette capacité — sans les effectifs d’une équipe de sécurité complète — est le cœur de notre service RSSI externalisé. Le playbook ci-dessous, c’est à quoi cette capacité ressemble en pratique.
Le playbook en cinq étapes
Cinq étapes, dans l’ordre. Chacune a une seule mission. Imprimez-les, posez les coordonnées à côté de l’étape un, et vous tenez quelque chose qu’une personne épuisée peut suivre à 2 h du matin.
1. Préparer — avant tout incident
La préparation est la seule étape que vous pouvez mener calmement : elle pèse donc le plus lourd. Désignez un responsable d’incident et un suppléant (pour ne jamais dépendre d’un seul téléphone). Rédigez un plan d’une page : qui décide, qui communique, qui appeler. Mettez en place un canal de communication de secours — un groupe sur les téléphones personnels ou une messagerie distincte — car si votre messagerie ou votre réseau est compromis, vous ne pouvez pas y coordonner la réponse. Conservez des sauvegardes hors ligne et testées (une sauvegarde jamais restaurée est un espoir, pas une sauvegarde). Et inscrivez un numéro sur le plan : un prestataire de détection managée (MDR), un contrat de réponse à incident, ou un spécialiste joignable hors heures ouvrées.
2. Détecter et trier
Sans SOC, la détection vient de deux sources : une alerte de votre protection des postes ou de votre service de détection managée, ou un humain (« mes fichiers ont l’air bizarres »). La compétence, c’est le tri : en quinze minutes, répondez à deux questions — est-ce réel, et quelle gravité. Vérifiez si cela se propage, ce qui est touché, et si des données sont sorties. Si le seuil est franchi, déclarez l’incident à voix haute. Le nommer fait basculer l’équipe de « est-ce un bug » à « nous déroulons le plan ».
3. Confiner — et préserver les preuves
Le confinement, c’est la première heure, et c’est là que l’instinct vous trahit. Isolez les machines touchées du réseau — débranchez le câble ou coupez le Wi-Fi — mais ne les éteignez pas et ne les effacez pas. Une machine éteinte ou réinstallée détruit les preuves dont vous aurez besoin pour savoir jusqu’où l’attaquant est allé, s’il est encore présent, et quoi écrire dans votre rapport réglementaire. Débrancher, pas supprimer. Changez les identifiants qui comptent (comptes admin, accès distant, messagerie) depuis un appareil sain.
4. Éradiquer et rétablir
Ce n’est qu’une fois le périmètre compris que vous retirez le point d’ancrage : fermez la porte d’entrée, supprimez la persistance, et reconstruisez ou restaurez les systèmes touchés à partir d’une sauvegarde saine antérieure à la compromission. Réinitialisez largement les mots de passe et forcez une nouvelle authentification. Validez chaque système avant de le reconnecter : restaurer le maliciel en même temps que les données est une manière courante et démoralisante de tout recommencer. Rétablissez avec méthode, pas à la vitesse que réclame la panique.
5. Notifier — et s’améliorer
C’est l’étape que les petites structures oublient, et c’est désormais une échéance légale, pas une politesse.
Si vous relevez de NIS2, l’article 23 fixe une horloge : une alerte précoce dans les 24 heures suivant la prise de connaissance d’un incident important, une notification plus complète sous 72 heures, et un rapport final sous un mois.
En France, cette horloge ne court pas encore. Le projet de loi résilience a été adopté par le Sénat en mars 2025 et voté en commission spéciale à l’Assemblée nationale le 10 septembre 2025, sans jamais être inscrit en séance publique ; le 8 juillet 2026, la Commission européenne a saisi la Cour de justice. Aucune date d’examen ne figure au dossier législatif, et personne ne peut honnêtement vous en donner une — de sorte que les obligations NIS2 d’une entreprise française sont à venir plutôt qu’en vigueur. L’ANSSI accueille déjà les entités concernées sur MonEspaceNIS2, et le CERT-FR reste votre point de contact en cas d’incident. En Belgique, le CCB supervise depuis octobre 2024 et audite depuis avril 2026 ; au Luxembourg, la loi du 5 mai 2026 est en vigueur. La Suisse, hors UE, n’est pas soumise à NIS2, mais elle applique depuis avril 2025 sa propre obligation de signalement sous 24 heures à l’OFCS (ex-NCSC). Autrement dit : à Paris, l’étape 5 se répète ; à Bruxelles, à Luxembourg et à Berne, elle s’exécute.
Deux autres horloges peuvent tourner en même temps. Si des données personnelles ont été exposées, l’article 33 du RGPD donne 72 heures pour notifier la CNIL. Et si vous vendez un produit comportant des éléments numériques, le règlement sur la cyberrésilience (CRA) fait tourner la sienne depuis le 11 septembre 2026. L’article 14 prévoit deux déclencheurs indépendants — une vulnérabilité activement exploitée dans votre produit, et un incident grave affectant sa sécurité — et chacun laisse 24 heures pour adresser une alerte précoce à l’ENISA et à votre CSIRT coordinateur, puis 72 heures pour la notification. Les rapports finaux diffèrent : 14 jours après la mise à disposition d’un correctif ou d’une mesure d’atténuation pour la vulnérabilité, un mois après la notification pour l’incident. C’est l’horloge la plus déroutante, parce qu’elle peut démarrer quand un client vous signale que ce que vous lui avez vendu est attaqué — et pas seulement quand il se passe quelque chose sur votre réseau. Nous avons cartographié l’ensemble dans Un incident, trois régulateurs ; nos services de conformité NIS2 et notre accompagnement CRA existent en grande partie pour rendre ces délais tenables plutôt que terrifiants.
Puis faites ce que le NIST met désormais le plus en avant — vous améliorer. Une revue courte et honnête de ce qui a marché et de ce qui a échoué, réinjectée dans l’étape un, transforme une mauvaise nuit en un plan plus solide.
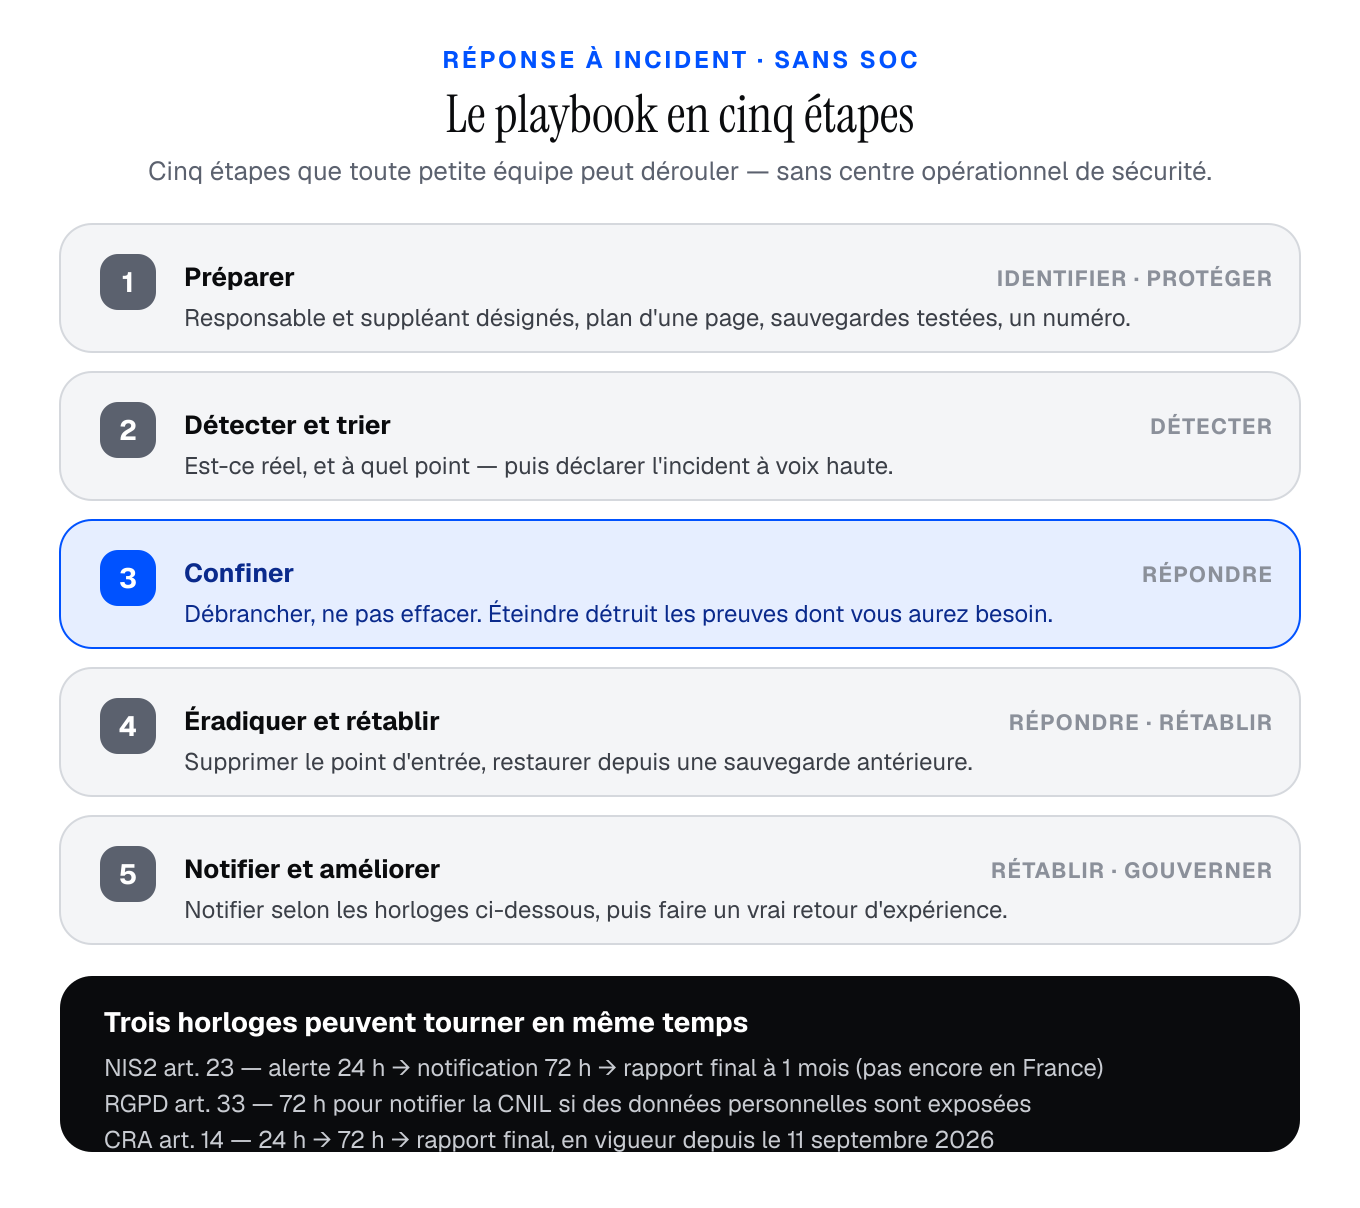 Cinq étapes que toute petite équipe peut dérouler — alignées sur les fonctions de réponse du NIST et l’horloge de notification NIS2.
L’erreur qui transforme un incident en crise
Les incidents qui deviennent des catastrophes mémorables partagent presque toujours l’une de trois erreurs, et aucune ne suppose un attaquant sophistiqué. La première est de détruire les preuves — effacer ou réinstaller la première machine compromise avant que quiconque ait compris l’intrusion, vous laissant incapable de répondre au régulateur ou de savoir si l’intrus détient encore une clé. La deuxième est de coordonner la réponse à l’intérieur du système compromis, de sorte que l’attaquant lit votre plan dans votre propre messagerie. La troisième est de payer une rançon par réflexe, sans confinement, finançant souvent une seconde extorsion parce que l’accès n’a jamais été refermé. Chacune est une décision, pas une défaillance technique — c’est le même constat que nous faisions dans 5 signes que votre entreprise est déjà compromise et que nous retracions heure par heure dans Anatomie d’une attaque par rançongiciel : au moment où vous réagissez, le coût est fixé par une préparation faite, ou non, des mois plus tôt.
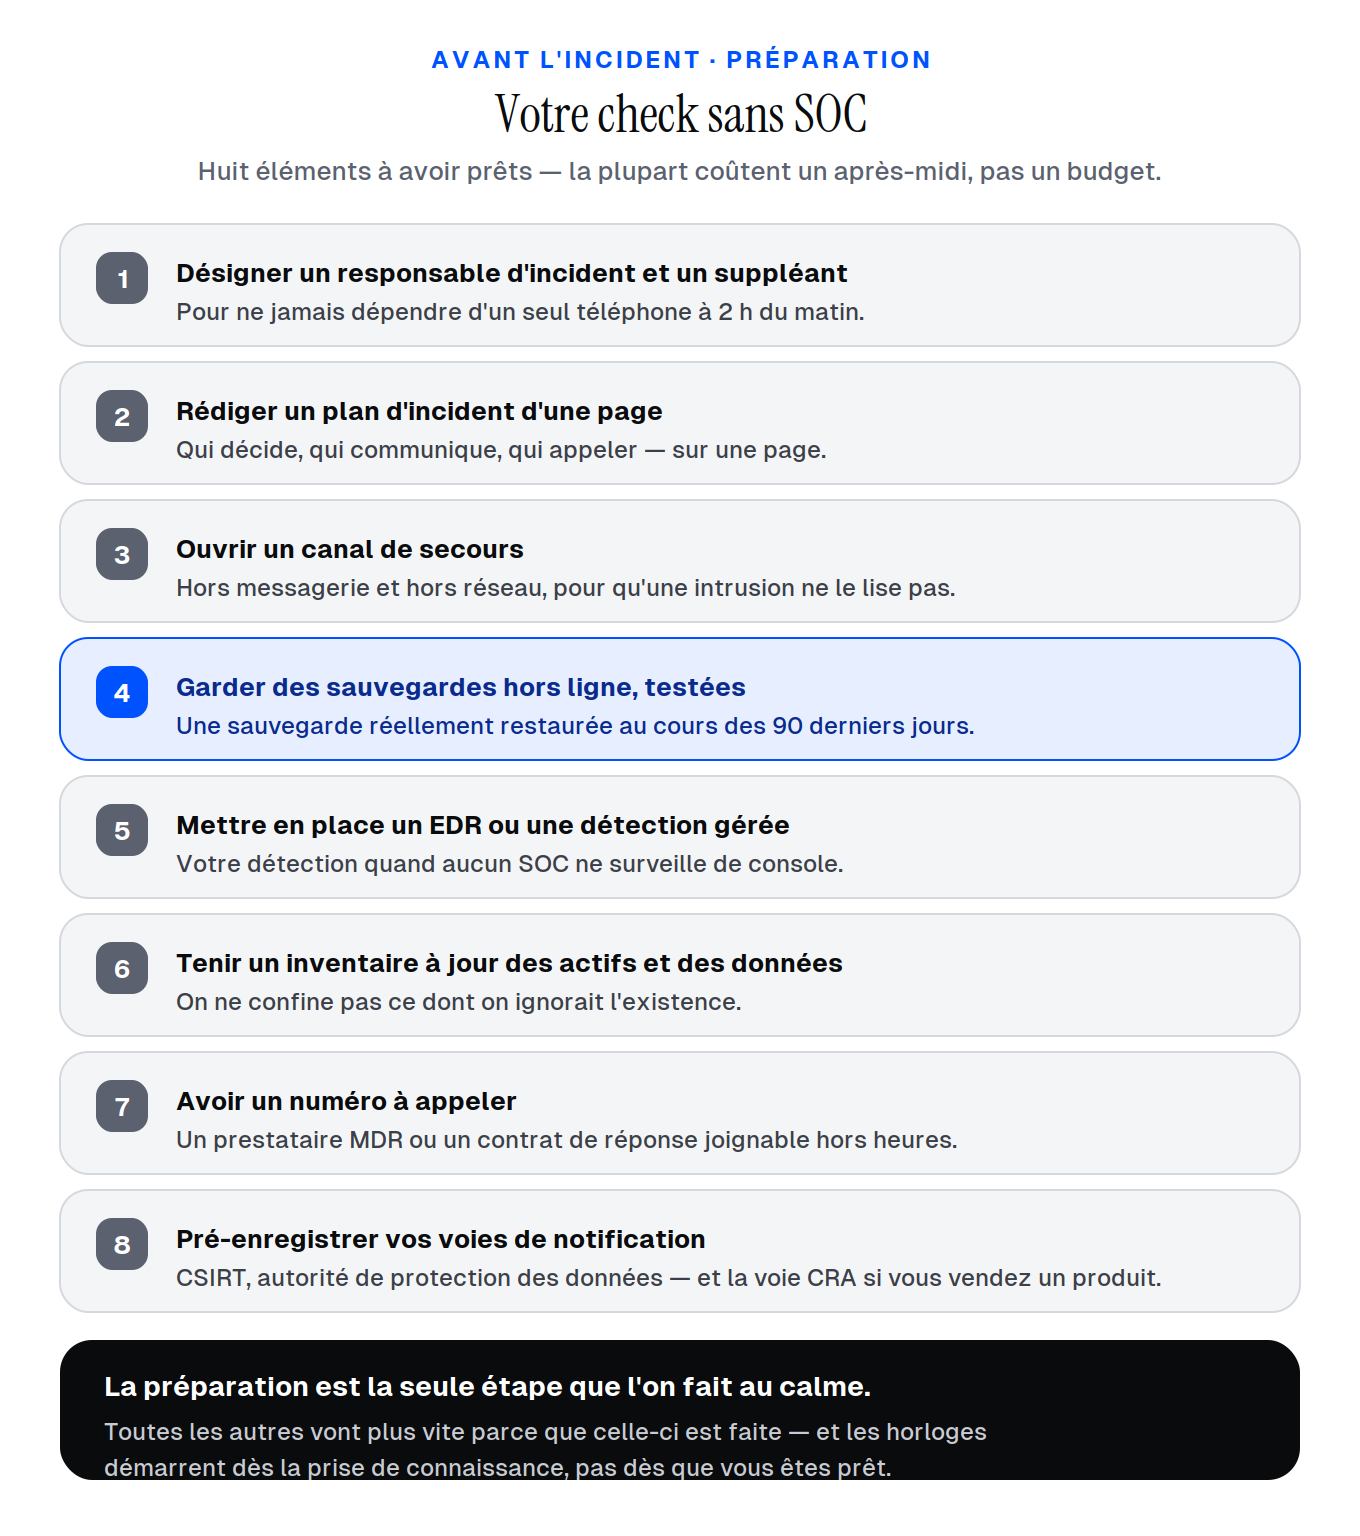 Les huit éléments à avoir en place avant un incident — la différence entre une mauvaise matinée et un mauvais trimestre.
Ce qu’il faut mettre en place cette semaine
Vous n’avez pas besoin d’un cycle budgétaire pour commencer. Cette semaine, désignez votre responsable d’incident et son suppléant et inscrivez leurs numéros sur un plan d’une page. Ouvrez un canal de secours et testez-le. Confirmez que vous disposez d’une sauvegarde réellement restaurée au cours des 90 derniers jours. Enregistrez dès maintenant, au calme, les coordonnées de votre CSIRT national (en France, le CERT-FR ; en Belgique, le CCB/CERT.be ; au Luxembourg, le CIRCL) et de votre autorité de protection des données, pour que personne ne les cherche à 2 h du matin. Si vous vendez un logiciel ou un produit connecté, ajoutez à côté la voie de notification CRA — elle est ouverte depuis septembre et la plupart des équipes produit ne s’en sont jamais servies. C’est l’essentiel d’une capacité de réponse opérationnelle, et cela ne coûte qu’un après-midi.
Passer à l'étape suivante
Parlez à un praticien de la sécurité, pas à un commercial.
Vingt-cinq minutes, sans présentation commerciale, sans séquence de relance. Nous parlons de votre situation, de votre horizon réglementaire à court terme et de la pertinence d'un accompagnement.